
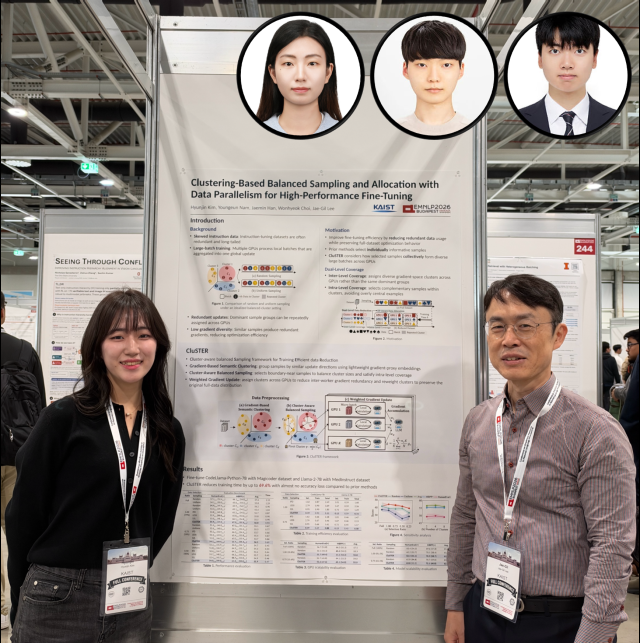
طور فريق بحثي من معهد كايست (KAIST) تقنية جديدة تقلل وقت التدريب الإضافي لتعليم الذكاء الاصطناعي مجالات متخصصة مثل الطب والبرمجة بنسبة تصل إلى 69.6%. وتتيح هذه التقنية اختزال وقت التدريب من 10 ساعات إلى حوالي 3 ساعات فقط، من خلال تقليل البيانات المتشابهة في التأثير على التعلم وتوزيع البيانات المختلفة بشكل متساوٍ على عدة وحدات معالجة رسومات (GPU).
أعلن معهد كايست اليوم أن فريق البحث برئاسة الأستاذ لي جاي جيل من قسم علوم الحاسوب طور تقنية جديدة لضبط النماذج اللغوية الكبيرة تسمى "كلستر" (CluSTER)، والتي تقوم بتجميع واختيار البيانات التي تؤثر بشكل متشابه على التعلم وتوزيعها بشكل متوازن على عدة وحدات معالجة رسومات.
الضبط الدقيق هو عملية تعليم الذكاء الاصطناعي الذي يتمتع بمعارف واسعة نصوصاً إضافية متخصصة مثل مسائل البرمجة وحلولها أو الأسئلة والإجابات الطبية، بهدف تخصيصه في مجال معين. نظراً لكمية الحسابات الكبيرة المطلوبة، تقوم عدة وحدات معالجة رسومات بتقسيم ومعالجة بيانات التدريب. وحدات معالجة الرسومات هي دوائر إلكترونية متخصصة تؤدي العمليات الحسابية المطلوبة لتدريب الذكاء الاصطناعي بسرعة عالية. عند توزيع البيانات بشكل عشوائي، قد تقوم عدة وحدات معالجة برمعالجة بيانات متشابهة التأثير بشكل متكرر. وهذا يؤدي إلى تقليل الفائدة التعليمية مقابل حجم الحسابات المستثمرة، مشابهاً لحل نفس نوع المسائل بشكل متكرر بدلاً من التنويع.
تقوم تقنية كلستر أولاً بتحليل تأثير كل بيانة على تدريب الذكاء الاصطناعي وتجميع البيانات المتشابهة معاً. لا تُستخدم معايير مثل التناول لنفس الموضوع أو استخدام كلمات متشابهة. بل يتم تصنيف المسائل المختلفة ظاهرياً ضمن مجموعة واحدة إذا كانت تعلم الذكاء الاصطناعي نفس المهارات الحسابية. هذا يشبه تعليم الطالب الجمع من خلال مسائل مختلفة كـ"جمع تفاحتين وثلاث تفاحات" و"جمع قلمين وثلاثة أقلام"، فالعملية الحسابية المستفادة واحدة رغم اختلاف السياق.
بعد ذلك، يتم انتقاء البيانات من كل مجموعة وتوزيعها على وحدات المعالجة المختلفة بحيث تعالج كل منها معلومات تدريبية متنوعة. هذا يشبه اختيار مسائل متنوعة من مجموعة تمارين بدلاً من حذف المسائل المتشابهة فقط، مع الحفاظ على جميع الأنواع المختلفة الأساسية. الميزة تكمن في عدم الاقتصار على تقليل حجم البيانات فحسب، بل في ضمان استخدام وحدات المعالجة المختلفة للبيانات المختارة بكفاءة عالية.
اختبر الفريق البحثي التقنية على ثلاثة مجموعات بيانات للتدريب في مجالي البرمجة والطب، وطبقها على نماذج لغوية كبيرة بحجم حوالي 7 مليارات و13 مليار معامل، مع إجراء 8 اختبارات تقييم أداء مختلفة. المعاملات هي قيم رقمية داخلية يقوم الذكاء الاصطناعي بتعديلها أثناء التدريب ويستخدمها لتعكس المعرفة المكتسبة في الإجابات. اختار الفريق فقط حوالي 31% من إجمالي البيانات للتدريب، وحقق الحفاظ شبه كامل على أداء النموذج بينما خفض وقت التدريب بنسبة تصل إلى 69.6%. أجريت التجارب بشكل أساسي في بيئة تحتوي على 4 وحدات معالجة رسومات، وأظهرت أداءً متفوقاً حتى في بيئة 8 وحدات معالجة رسومات مقارنة بالطرق التقليدية.
تُظهر النتائج إمكانية تحسين كفاءة تدريب الذكاء الاصطناعي من خلال الاختيار والتوزيع الذكي للبيانات وحده، دون الحاجة لاستثمار وحدات معالجة إضافية. وفقاً لفريق البحث، يمكن للمؤسسات والشركات توفير الوقت وتكاليف استخدام وحدات المعالجة عند تطوير نماذج ذكاء اصطناعي متخصصة لأغراض محددة مثل خدمة العملاء وتوفير الدعم البرمجي والإجابة على الأسئلة الطبية.
قال الأستاذ لي جاي جيل: "لتحسين كفاءة تدريب الذكاء الاصطناعي، لا يكفي فقط استخدام مزيد من وحدات المعالجة، بل يجب أيضاً اختيار البيانات المراد تدريبها بذكاء وحكمة. تحمل هذه الدراسة أهمية خاصة في تحسين استخدام موارد وحدات المعالجة الموجودة بالفعل وتقليل عبء تدريب نماذج الذكاء الاصطناعي الكبيرة".
* تمت ترجمة هذا المقال تلقائيًا بواسطة الذكاء الاصطناعي.