
منصة المكتبة المشتركة تعرض مجموعات بيانات نصية وصورية ودوسيمات حروفية
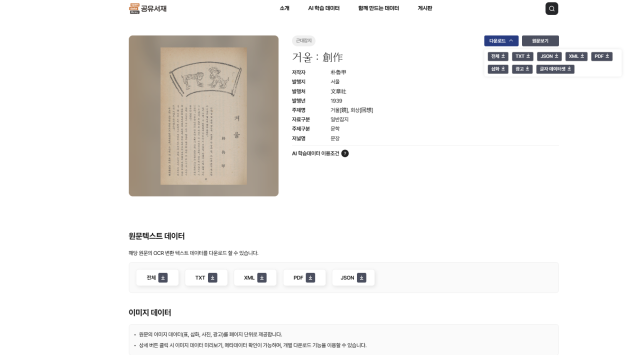
ستتاح للعامة مجموعة بيانات تزيد عن 38 مليون و 300 ألف وحدة تشمل الكتب والجداول والرسوم التوضيحية والإعلانات والصور.
أعلنت المكتبة الوطنية المركزية في كوريا الجنوبية أنها تفتح للجمهور لأول مرة بيانات تدريب الذكاء الاصطناعي المُشيَّدة من الوثائق الوطنية.
تتضمن البيانات المفتوحة بيانات نصية (صيغ Hidden Text PDF و XML و TXT و JSON) بواقع 3974 كتاب ومجموعة، وبيانات صور تشمل جداول وصور توضيحية وإعلانات وصور بإجمالي 21485 وحدة، وبيانات وصفية ودوسيمات حروفية بمستوى الحرف الفردي تبلغ 38 مليون و 300 ألف وحدة، بإجمالي 38 مليون و 330 ألف وحدة.
ترافق هذا الإفتاح للبيانات إعادة تطوير منصة "المكتبة المشتركة" السابقة لتصبح منصة محسَّنة خصيصاً لاستخدام بيانات تدريب الذكاء الاصطناعي. ركّز التطوير على تعزيز سهولة الاستخدام بحيث يتمكن الجميع من الاستفادة من المنصة بسهولة لأغراض متعددة منها التعلم الآلي والبحث الأكاديمي وتطوير التطبيقات والخدمات وإنتاج المحتوى.
تتألف البيانات المفتوحة من نصوص رقمية محفوظة لدى المكتبة الوطنية المركزية ممن تم حل قضايا الحقوق الفكرية فيها، بما في ذلك المجلات الحديثة من أربعينيات وخمسينيات القرن العشرين، والمنشورات الحكومية والكتب المدرسية من أربعينيات وستينيات القرن العشرين، والمواد الصادرة عن المكتبة الوطنية المركزية والأوراق الأكاديمية ذات الوصول المفتوح التي حصلت على تصريح الاستخدام في تدريب الذكاء الاصطناعي. يمكن للجميع الاطلاع على هذه البيانات وتنزيلها واستخدامها بحرية عبر منصة "المكتبة المشتركة".
يتم توفير البيانات النصية بصيغ عالية الجودة معالجة بحيث يسهل على الذكاء الاصطناعي التعامل معها، مما يسمح باستخدامها مباشرة في البحث وتطوير الخدمات. وبالنسبة لدوسيمات الحروف، يمكن استخدامها مباشرة في تدريب نماذج الذكاء الاصطناعي، مما يتيح للشركات الصغيرة والناشئة، التي تواجه صعوبات في الحصول على بيانات ضخمة، فرصة واسعة لاستخدامها في تطوير تقنيات ذات صلة مثل التعرف البصري على الحروف والمعالجة الطبيعية للغات.
تم أيضاً تعزيز وظائف منصة "المكتبة المشتركة" المعاد تطويرها لدعم أبحاث الذكاء الاصطناعي والعلوم الإنسانية الرقمية، وتوسيع استخدام البيانات العامة. من خلال تنظيم ومعالجة مخزون ضخم من مواد المعرفة الرقمية بصيغ قابلة لتدريب الذكاء الاصطناعي عليها، أصبح من الممكن الآن إجراء أبحاث إنسانية واسعة النطاق قائمة على البيانات الضخمة بطريقة لم تكن ممكنة سابقاً. يُتوقع أن يتمكن الباحثون من إجراء أبحاث العلوم الإنسانية الرقمية بسهولة أكبر، حيث يحللون مختلف الموارد كالنصوص والسجلات والصور باستخدام الذكاء الاصطناعي ويستخرجون معاني جديدة منها.
وللإشارة إلى الأهمية، فإن إتاحة الوثائق الوطنية التي تم حل قضايا حقوقها الفكرية بصيغة قابلة للاستخدام المباشر في تدريب الذكاء الاصطناعي أمر ذو دلالة كبيرة. ومن المتوقع أن يخفف هذا الإجراء من الأعباء المالية وقانونية التي طال أمدها للباحثين والشركات الصغيرة والناشئة في الحصول على بيانات التدريب.
تحسّنت أيضاً تجربة المستخدم على المنصة لتصبح أكثر ملاءمة للمستخدمين. تم تطبيق تصميم واجهة بديهي وهياكل استكشاف منظمة حسب نوع المواد ونوع الصور، مما يسمح لأي شخص بالوصول إلى البيانات بسهولة دون الحاجة إلى إجراءات تسجيل منفصلة، مما يتيح للباحثين المتخصصين والمستخدمين العاديين البحث عن المواد واستخدامها بسهولة.
تخطط المكتبة الوطنية المركزية لإتاحة بيانات نصية لحوالي 300 رواية حديثة باللغة الكورية بنهاية هذا العام، وستواصل توسيع بناء البيانات وإتاحتها. وستعمل على تحسين خدمات استخدام الذكاء الاصطناعي، وتطوير منصة "المكتبة المشتركة" لتصبح منصة بيانات تنمو وتتطور بشكل مستمر.
قالت إي هيون-جو، رئيسة قسم تخطيط المعلومات الرقمية بالمكتبة الوطنية المركزية: "سنواصل توسيع نطاق إتاحة البيانات بشكل مطرد لننشئ مكتبة في عصر الذكاء الاصطناعي حيث يستطيع الجمهور بأكمله الاستفادة من موارد المعرفة العامة."
* تمت ترجمة هذا المقال تلقائيًا بواسطة الذكاء الاصطناعي.