
فريق البروفيسور لي يون-تشانغ بجامعة UNIST يطور أداة تشخيصية 'إيكوتريس'
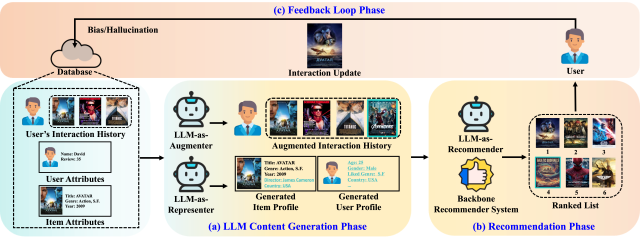
أظهرت نتائج بحثية جديدة أن أنظمة التوصية المدعومة بنماذج اللغات الكبرى (LLM) قد تكرر الانحيازات والأخطاء عندما تعيد تعلم نتائج التوصيات التي طرحتها بنفسها، مما يؤدي إلى تركز حول عناصر معينة وتوصيات خاطئة متكررة.
أعلنت جامعة العلوم والتكنولوجيا بأولسان (UNIST) في الثامن من الشهر الجاري أن فريق البروفيسور لي يون-تشانغ بكلية الذكاء الاصطناعي طور أداة تشخيصية تسمى "إيكوتريس" (EchoTrace) لتتبع عمليات الانحياز والأخطاء المتراكمة في أنظمة التوصية القائمة على نماذج اللغات الكبرى. استخدم الفريق البحثي هذه الأداة لتحليل ثلاث طرق مختلفة: عندما ينشئ نموذج اللغة قائمة التوصيات مباشرة، أو عندما يولد ملفات تعريف المستخدمين وبيانات التدريب.
عندما أنشأ نموذج اللغة الكبير قائمة التوصيات مباشرة، بلغت نسبة اقتراح عناصر غير موجودة في مجموعة التوصيات 4.07% للأفلام و7.4% للكتب و13.14% للمتاجر. كما أن الوظيفة المتوقعة للمستخدم بناءً على سجل مشاهدة الأفلام اختلفت عن السجل الفعلي بنسبة 93.16%. كما أظهرت البيانات المولدة للتدريب انحيازاً نحو أنواع وقطاعات معينة. في التوصيات النهائية، ظهرت العناصر الشهيرة بتكرار أعلى مقارنة بسجلات الاستخدام الفعلية.
حتى عند تكرار عملية إعادة تعلم نتائج التوصيات خمس مرات، لم تختفِ الانحيازات والأخطاء الأولية. في بعض الأنظمة، ازداد التركز نحو العناصر الشهيرة. بشكل خاص، كان نموذج التوصية المباشرة للأفلام يعتمد بشدة على التوصيات السابقة، حيث أن 86 إلى 92 مستخدماً من كل 100 مستخدم اعتمدوا على الأفلام الموصى بها سابقاً عند اختيار الفيلم التالي. أدت "حلقة التغذية الراجعة"، حيث تتعلم التوصيات التي وضعها الذكاء الاصطناعي من خلال سجلات اختيار المستخدمين وتنعكس في التوصيات اللاحقة، إلى استمرار الانحيازات والأخطاء الأولية.
قال البروفيسور لي: "أرسى هذا البحث أساساً يتيح التشخيص المنهجي لكيفية تراكم وتضخيم الانحيازات والهلاوس في أنظمة التوصية القائمة على نماذج اللغات الكبرى خلال عمليات التوصية المتكررة، وذلك وفقاً لدور نموذج اللغة."
* تمت ترجمة هذا المقال تلقائيًا بواسطة الذكاء الاصطناعي.